

セキュリティを重視する企業がAI導入を検討すると、多くがぶつかるのが「ローカルLLM(自社内でAIを動かす方式)にすべきか、クラウド型の法人向け生成AIサービスにすべきか」という論点です。どちらにも明確な強みと弱みがあり、正解は会社の規模・扱う情報・IT体制によって変わります。この記事では、2つの方式の仕組みの違いから、コスト・精度・セキュリティの比較、自社に合った選び方の判断基準までをわかりやすく解説します。
ローカルLLMとは
ローカルLLMとは、大規模言語モデル(LLM)を自社のパソコンやサーバーの中で動かす使い方を指します。ChatGPTのようなクラウド型のサービスは、入力した文章がインターネット越しに提供元のサーバーへ送られ、そこで処理された結果が返ってきます。ローカルLLMはその処理を、手元の機械の中だけで完結させます。
成り立ちを支えているのが、重み(モデルの中身にあたる数値の集まり)が公開されているモデルの存在です。こうしたモデルはオープンウェイトモデルと呼ばれ、誰でもダウンロードして自分の環境で動かせます。GoogleのGemma、AlibabaのQwen、MetaのLlamaなどが代表例です。
混同されやすいのですが、ローカルLLMは特定の製品名ではありません。どのモデルを、どの機械で、どのソフトを使って動かすかという組み合わせの総称です。ここを押さえておくと、後の判断がぐっと楽になります。
ローカルLLMはどう動くのか
必要なものは大きく3つです。
- モデル本体:学習済みの重みファイル。数GBから数百GBまで幅があります
- 推論エンジン:モデルを読み込んで動かすソフト。Ollama や LM Studio が代表的です
- 計算する機械:主にGPU。搭載されているVRAM(GPU側のメモリ)の量が使えるモデルの上限を決めます
クラウド型との違いは、この3つを誰が用意して誰が面倒を見るか、という一点に集約されます。クラウド型は3つとも提供元が持っています。ローカルLLMは3つとも自社で持ちます。安全性の話に見えて、実態は運用責任をどちらが負うかの話です。
なぜ今、法人で検討されるのか
相談が増えている背景には、はっきりした理由が3つあります。
1. 入力した情報を外に出したくない
最も多い動機です。顧客情報や設計データ、未公開の財務資料を、社外のサーバーに送ること自体を避けたい。特に受託開発や士業のように、取引先から預かった情報を扱う業種で強く出ます。
2. 使った分だけ課金される仕組みを避けたい
クラウド型のAPIは使うほど費用が増えます。処理する量が読めない業務、たとえば大量の文書を一括で要約させるような使い方では、月々の請求が事前に見積もれません。手元で動かせば、電気代を除けば追加費用はかかりません。
3. インターネットにつながらない場所で使いたい
工場の製造ラインや、外部ネットワークから切り離された環境です。数は多くありませんが、この条件がある場合はローカルLLM以外の選択肢がありません。
逆に言えば、この3つのどれにも当てはまらない場合、ローカルLLMを選ぶ積極的な理由はほとんどありません。この記事の後半で、その判断の仕方を具体的に整理します。
動かすのに何が必要か
いちばん多い質問がここです。結論から言うと、モデルのファイルサイズが、必要なVRAMのおおよその目安になります。
モデルの大きさはパラメータ数で表され、7B(70億)、13B、70Bのように書かれます。そのままでは容量が大きすぎるため、実際には量子化という圧縮をかけて使うのが一般的です。4bit量子化なら、ファイルサイズは16bit(FP16/BF16)で配布された元のモデルに対して、おおむね3分の1から4分の1程度まで下がります。
実務上は、次のように考えると外しません。
- モデルのファイルサイズ + 会話の長さに応じた余裕が、必要なVRAMの目安
- VRAMに収まらないと、動かないか、極端に遅くなります
- 長い文書を扱うときは、会話の長さに応じた余裕が数GB単位で必要になることがあります
- ノートPCの内蔵GPUでは、小さいモデルしか現実的に動きません
Ollamaのモデルページには各サイズのファイル容量が表示されます。まずそこを見て、手元のGPUのVRAMと突き合わせる。これが最短の確認方法です。
用途によって必要な大きさは変わる
文章の要約や定型的な言い換えであれば、小さめのモデルでも実用になります。一方で、複雑な条件を整理させたり、長い契約書を読ませて論点を出させたりする用途では、モデルを大きくしないと精度が足りません。用途を決めてから機械を選ぶのが順番です。機械を先に買うと、たいてい足りなくなります。
どのモデルを選ぶか
2026年9月時点で、Ollamaの公式ライブラリには239のモデルが並んでいます(埋め込みモデルや画像対応モデルを含む総数)。提供されているサイズを実際に確認すると、次のような幅があります。
| モデル | 公開されているサイズ | 性格 |
|---|---|---|
| Gemma 3(Google) | 270M / 1B / 4B / 12B / 27B | 1枚のGPUで動かすことを想定した構成。270M・1Bはノートパソコンでも動く軽量版 |
| Qwen 3(Alibaba) | 0.6B / 1.7B / 4B / 8B / 14B / 30B / 32B / 235B | 小型から超大型まで選択肢が広い |
| Llama 3.1(Meta) | 8B / 70B / 405B | 大型志向。8B以外はGPUを複数枚必要とする規模 |
出典:Ollama公式ライブラリの各モデルページ(2026年9月時点で確認)。モデルは頻繁に更新されるため、導入前に最新の提供状況を確認してください。
日本語で使うときの注意点
ここが実務でいちばんつまずく場所です。Ollamaの公式ライブラリ239モデルには、モデル名で確認した限り、日本語に特化したモデルは含まれていません。日本語特化モデルを使いたい場合は、Hugging Faceなどの配布元から個別に持ち込み、自分で変換や設定を行う必要があります。
おすすめモデルを何本も並べた記事は多いのですが、この一手間に触れているものはほとんどありません。ダウンロードして終わりではないという点は、検討の初期に知っておいた方がよい情報です。
なお、GemmaやQwenのような多言語対応モデルも日本語を扱えます。日本語特化モデルほど自然ではない場面もありますが、まず試すならこちらの方が手間はかかりません。
実行ツールと、始めるまでの手順
代表的な実行ツールは2つです。
- Ollama:コマンドで操作する形式。サーバーに入れて社内から使わせる構成に向いています
- LM Studio:画面付きのアプリ。まず個人の端末で試したい場合はこちらが早いです
試すだけなら、手順はそれほど多くありません。
- 手元のGPUのVRAM容量を確認する
- ツールをインストールする
- VRAMに収まるサイズのモデルを選んでダウンロードする
- 日本語で質問して、返ってくる内容の質を確かめる
ここまでは半日あれば終わります。問題はこの先です。社内の全員が使える形に整え、誰が何を入力したかを把握し、モデルを更新し続ける。この運用に入った瞬間、必要な手間が一段変わります。
ライセンスの確認を飛ばさない
見落とされがちですが、公開されているモデルが、そのまま商用利用してよいとは限りません。
ライセンスはモデルごとに異なります。Apache 2.0のような一般的なオープンソースライセンスが付いているものもあれば、提供元が独自に定めた利用規約が付くものもあります。後者には、利用規模に応じた条件や、用途の制限が書かれている場合があります。
確認すべきなのは次の3点です。
- 商用利用が許可されているか
- 生成した文章や画像を、自社のサービスに組み込んでよいか
- 再配布や、別のモデルの学習に使うことに制限がないか
いずれもモデルの配布ページに記載があります。導入を決める前に、法務またはそれに準ずる立場の人が一度目を通す工程を入れてください。動かせることと、業務で使ってよいことは別の話です。
ローカルLLMとクラウド型法人向け生成AIの違い
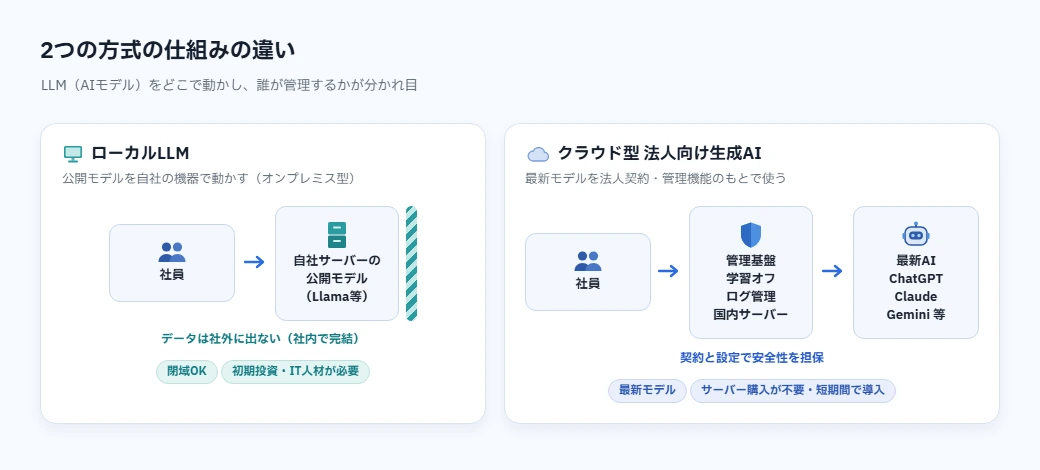
まず用語を整理します。LLM(大規模言語モデル)とは、ChatGPTやClaudeの中身にあたるAIモデルのことです。企業での使い方は、モデルをどこで動かすかによって大きく2つに分かれます。
- ローカルLLM:LlamaやGemmaなどの公開されているAIモデルを、自社のサーバーやPCにダウンロードして動かす方式です。オンプレミス型・セルフホスト型とも呼ばれます。データは自社の機器の中だけで処理され、原則として外部に出ません。
- クラウド型の法人向け生成AIサービス:ChatGPT・Claude・Geminiなどの最新モデルを、法人契約のもとでインターネット経由で使う方式です。入力データを学習に使わない契約、管理者によるログ管理、国内サーバーでの履歴管理といった法人向けのセキュリティ・管理機能が付きます。UPGEAR AIもこの方式です。
なお「セキュリティ特化型LLM」といった呼び方を見かけることもありますが、モデル自体が違うわけではありません。違いはあくまで、動かす場所と、契約・管理の仕組みにあります。
比較一覧表
2つの方式の違いを一覧にまとめると、次のようになります。
| 項目 | ローカルLLM | クラウド型 法人向け生成AIサービス |
|---|---|---|
| データの所在 | 自社内で完結(原則外部に出ない) | 外部サービスを経由(学習オフ・国内保存等は契約と設定で担保) |
| AIの性能 | 公開モデルを利用。最新のクラウド最上位モデルには及ばない場面が多い | ChatGPT・Claude・Gemini等の最新・最上位モデルをそのまま利用できる |
| 初期費用 | GPUサーバー等の投資が必要になりやすい(当社が確認した範囲では、規模により数十万円台から) | 不要〜数万円台。サービスにより初期設定費が発生する場合があります |
| 月額費用 | 電気代・保守・人件費が継続的にかかる | ID単価または定額のサービス利用料 |
| 導入スピード | 構築・検証に数週間〜数ヶ月かかることが多い | 最短数日〜数週間で利用開始できる |
| 必要な人材 | サーバー運用・モデル更新ができるIT人材が必要 | 専任者がいなくても運用できる(管理画面での設定が中心) |
| アップデート | モデルの入替・チューニングを自社で実施 | サービス側が新モデルへ随時対応 |
| 向いている組織 | 規制の厳しい業種、オフライン要件のある環境、IT部門が充実した企業 | 中小企業を含む一般的な企業、まず全社にAIを行き渡らせたい企業 |
※費用・期間は構成や規模により大きく変動します。目安としてお読みください。
ローカルLLMの強みと課題
強み:データが物理的に外へ出ない
ローカルLLM最大の価値は、入力したデータが自社の機器から外に出ないことです。設計図・ソースコード・研究データなど、外部送信そのものが契約や規制で制限されている情報を扱う場合には、ほぼ唯一の選択肢になります。インターネットに接続できない閉域環境でも動かせるのも、この方式ならではです。
課題:性能・コスト・人材の3つのハードル
一方で課題も明確です。第一に性能面。自社の機器で動かせる規模の公開モデルは、クラウドの最新・最上位モデルと比べると、複雑な文書作成や長文読解で見劣りする場面が多いのが実情です。第二にコスト面。実用的な速度で動かすにはGPUを積んだサーバーが必要で、初期投資に加えて電気代・保守費が継続的にかかります。第三に人材面。モデルの選定・入替・チューニング・サーバー運用を担えるIT人材が社内に必要で、担当者が辞めると運用が止まるという属人化リスクも抱えます。
クラウド型(法人向け生成AIサービス)の強みと課題
強み:最新モデルを、すぐ、全社で
クラウド型の強みは、ChatGPT・Claude・Geminiといった最新・最上位のAIをそのまま使えることです。AIの性能は業務品質に直結するため、この差は日々の実務で効いてきます。初期投資がほぼ不要で、アカウントを発行すれば数日で全社導入できるスピードも魅力です。新しいモデルが出ればサービス側が対応するため、自社での更新作業もありません。
課題:外部を経由する以上、契約と管理が生命線
課題は、データが外部サービスを経由することそのものです。だからこそ法人向けサービスでは、入力データを学習に使わない契約、会話履歴の国内サーバー管理、管理者によるアカウント・利用ログの一元管理といった仕組みで安全性を担保します。逆に言えば、こうした契約・管理機能のない個人向けAIを業務に使うのは、クラウド型の弱点がそのまま露出した状態であり、避けるべきです。
個人向けAIを業務に使う状態を避けるため、使う環境を会社で1つにまとめます。UPGEAR AI(アップギアAI)は、ChatGPT・Claude・Gemini・Perplexityを1つの契約で使える法人向けサービスです(人数無制限)。
実際にかかるコストの内訳
ローカルLLMは費用がかからないと説明されることがありますが、正確ではありません。かからないのは使った分だけ増える課金であって、費用そのものは発生します。内訳はこうなります。
| 費目 | 性格 | 見落とされやすい点 |
|---|---|---|
| GPUを含む機材 | 初期費用 | 使いたいモデルの大きさで金額が大きく変わる |
| 構築の工数 | 初期費用 | 社内でやるなら人件費、外に出すなら委託費 |
| 電気代 | 固定費 | GPUを常時動かす前提だと無視できない |
| 運用・保守の工数 | 固定費 | 止まったときに直せる人を置き続ける必要がある |
| モデルの入れ替え | 継続費用 | 新しいモデルが出るたびに検証と載せ替えが要る |
特に効いてくるのが最後の2つです。クラウド型では提供元が担っている作業が、そのまま自社の仕事として残ります。担当者が1人しかいない体制でこれを抱えると、その人が動けなくなった時点で全社のAI利用が止まります。
費用を比べるときは、機材の値段だけでなく、この運用を何年続けるつもりかを含めて計算してください。3年動かすなら、機材費よりも人の手間の方が大きくなることは珍しくありません。
導入でつまずきやすい5つの場所
相談を受けていて、繰り返し同じところで止まります。
1. 機械を先に買ってしまう
用途が決まる前にGPUを調達すると、いざ使いたいモデルがVRAMに収まらない、という事態になります。順番は、用途、モデル、機械です。
2. 精度が想像と違う
手元で動く規模のモデルは、複雑な読解や推論を伴う用途では、クラウドで提供されている最新の大規模モデルほどの精度が出にくいのが実情です。試した担当者は納得しても、実際に使う現場から使えないという声が上がり、そこで止まります。
3. 日本語で期待どおりに動かない
前述のとおり、日本語特化モデルは公式ライブラリから直接は入りません。この一手間で検証が長引きます。
4. 動かせる人が1人しかいない
構築できた人に運用が集中します。その人が異動や退職をすると、誰も触れない仕組みだけが残ります。
5. 誰が何を入力したかを把握できていない
社内に置いたから安全、とは限りません。利用ログを取る仕組みを作らないと、社外に出ていないだけで、中で何が起きているかは見えないままです。
業務から見た向き・不向き
| 使い方 | ローカルLLM | クラウド型 |
|---|---|---|
| 外部に出せない情報を扱う定型処理 | 向く | 契約と設定次第 |
| 大量の文書を一括で処理する | 向く(費用が増えない) | 量によっては割高 |
| ネットにつながらない環境での利用 | これしかない | 使えない |
| 複雑な資料の読み解きや企画の壁打ち | 精度が足りないことが多い | 向く |
| 全社員に配って日常的に使わせる | 運用負荷が重い | 向く |
| 最新モデルをすぐ使いたい | 載せ替えの手間がかかる | 向く |
実務では、片方に寄せるより使い分けが現実的です。外に出せない特定の処理だけをローカルで動かし、日常の業務は管理されたクラウド型で全社に配る。この形に落ち着く会社が多いのは、それぞれの弱点を互いに埋められるからです。
「ローカル=安全」とは限らない:セキュリティの正しい考え方
ここで強調したいのは、「ローカルは安全、クラウドは危険」という単純な図式は実態に合わないということです。

ローカルLLMでも、サーバーの設定ミスや管理者不足があれば、社内からの情報持ち出しや不正アクセスのリスクは残ります。また、社内のローカルLLMの性能に不満を持った社員が、個人契約の高性能なAIをこっそり使い始めれば、それはシャドーAIそのものです。使いにくい公式環境は、かえって管理外のAI利用を生む温床になります。
管理外のAIが社内で動いていないかは、追加の費用をかけずに確かめられます。手順は野良AI(シャドーAI)の見つけ方をご覧ください。
一方クラウド型でも、学習利用オフ・保存先の明確化・ログ管理という3点を契約と設定で押さえれば、実務上のリスクは大きく下げられます。重要なのは方式の選択そのものではなく、社員が実際に使いたくなる公式環境を用意したうえで、運用ルールとセットで管理することです。
社内で検討を進めるときの順番
いきなり機材を選ぶと失敗します。順番はこうです。
ステップ1|外に出せない情報を、具体的に書き出す
ローカルLLMを検討する理由の大半はここです。ただし「機密情報」とだけ書くと話が進みません。どの部署の、どの書類が、なぜ出せないのかを1行ずつ書き出してください。取引先との契約で禁じられているのか、社内規程なのか、担当者の心情なのかで、打つ手が変わります。契約上の制約が無いのであれば、クラウド型の設定と契約で解ける可能性が高くなります。
ステップ2|その情報を使う業務が、月にどれくらいあるか数える
月に数回しか発生しない処理のために、GPUサーバーと運用担当者を抱えるのは割に合いません。逆に毎日大量に流れる処理であれば、手元で動かす価値が出ます。頻度と量を数字にするのが、この段階の目的です。
ステップ3|小さいモデルで、その業務を試す
LM Studioを個人の端末に入れて、実際の書類に近いもので試します。ここで求める品質に届かなければ、より大きなモデルが必要になり、必要な機材の規模も上がります。試さずに機材を見積もらないでください。
ステップ4|運用を誰が担うかを決める
構築できる人と、3年間動かし続ける人は別です。担当者が1人しかいない場合、その体制自体がリスクになります。ここで人を確保できないなら、方式を見直した方が結果的に早く進みます。
ステップ5|クラウド型と並べて費用と手間を比べる
ここまで来て初めて、両方式を同じ土俵で比べられます。比べるのは初期費用だけでなく、3年間の運用工数を含めた総額です。
検討チェックリスト
会議に持ち込める形に整理しました。上から順に埋めてください。
| 確認項目 | これがはっきりしないと |
|---|---|
| 外に出せない情報を、書類名まで特定できているか | そもそも方式を選べない |
| 出せない理由は、契約・規程・心情のどれか | クラウド型で解けるかどうかが判断できない |
| その業務は月にどれくらい発生するか | 費用対効果が計算できない |
| 求める出力の品質を、実物で確認したか | 必要なモデルの規模が決まらない |
| 手元のGPUのVRAM容量を把握しているか | 動くモデルの上限が分からない |
| 使いたいモデルのライセンスを確認したか | 商用利用できない可能性が残る |
| 3年間、運用を担える人が2名以上いるか | 属人化して止まる |
| 誰が何を入力したかを記録する仕組みがあるか | 社内に置いても管理できていない |
| クラウド型と3年総額で比較したか | 初期費用だけ見て高い方を選ぶことになる |
このうち1つでも埋まらない項目があれば、まだ機材を選ぶ段階ではありません。
自社に合った選び方(判断フロー)
判断の目安は次のとおりです。
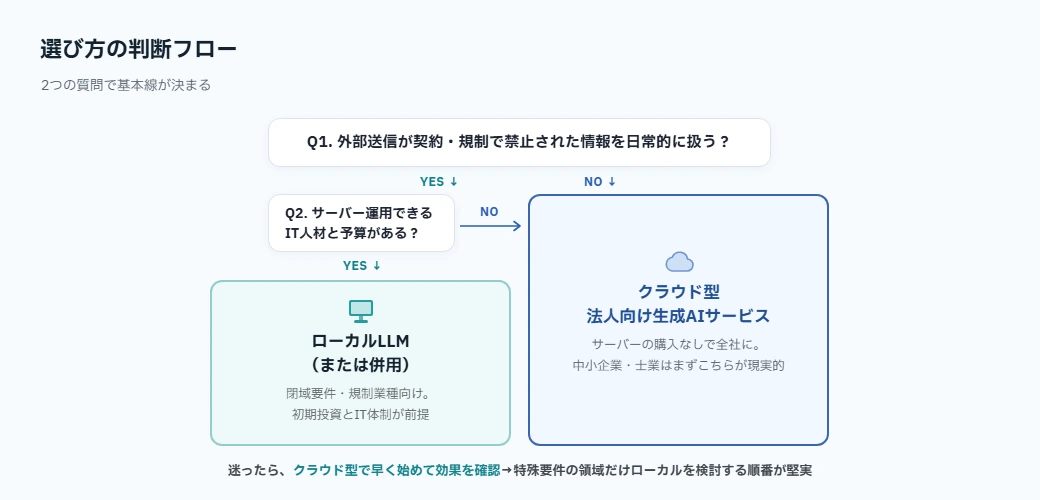
- ローカルLLMが向くケース:外部送信が契約・規制で明確に禁止されている情報を日常的に扱う。閉域・オフライン環境での利用が必須。サーバー運用を担えるIT部門があり、初期投資の予算も確保できる。
- クラウド型が向くケース:上記のような厳格な制約はなく、メール・資料作成・要約・リサーチなど一般的な業務でAIを全社活用したい。IT専任者が少ない。まずスピーディーに始めて効果を確かめたい。
- 併用(ハイブリッド)という選択肢:大企業では、最高機密の領域だけローカルLLM、日常業務はクラウド型、と使い分けるケースもあります。
結論の目安:中小企業や士業事務所を含む多くの企業にとって、現実的な第一歩はクラウド型の法人向け生成AIサービスです。初期投資と専任人材なしで、最新AIを安全な管理のもとで全社に行き渡らせることを優先し、将来、特殊な要件が生じた領域にだけローカルLLMを検討する、という順番が堅実です。
クラウド型サービスの具体的な選び方は法人向け生成AIサービスの比較記事で詳しく解説しています。
実際に採用されている3つの構成パターン
検討の行き着く先は、だいたい次の3つに分かれます。自社がどれに近いかを見てください。
パターンA|全社はクラウド型、一部だけローカル
いちばん多い形です。日常の文書作成や調べものは管理されたクラウド型で全社員に配り、外部に出せないと契約で定められた処理だけをローカルで動かします。運用の重さを、本当に必要な範囲に限定できるのが利点です。ローカル側は用途が限られるので、モデルも機材も小さく済みます。
パターンB|すべてローカル
外部ネットワークから切り離された環境や、業界の規制で外部送信が認められない場合に選ばれます。運用の負荷は最も重くなります。担当者を複数名確保できること、モデルの入れ替えを継続できる体制があることが前提条件です。人が確保できないまま踏み切ると、数年後に古いモデルが動いたまま放置される状態になりがちです。
パターンC|すべてクラウド型
契約と設定で必要な安全性を確保できるなら、これが最も早く、最も安く回ります。前章の7項目に書面で答えられるサービスを選べているかが分かれ目です。ここを詰めずに導入すると、現場が不安を理由に使わなくなり、結局シャドーAIが残ります。
どのパターンでも共通して必要なのは、誰が何を入力したかを会社が把握できていることです。方式の選択は、この前提を満たしたうえでの話になります。
クラウド型を選ぶなら、契約前に確認する7項目
ローカルLLMを見送ってクラウド型にする場合、確認すべきことははっきりしています。ここを詰めれば、社内で出せない情報の範囲は大きく狭められます。
- 入力データを学習に使わない設定になっているか。オプションではなく標準で適用されるか、社員ごとの操作が要らないかまで確認します
- 会話履歴と利用ログの保存先はどこか。国内か国外か、どの事業者の設備かを書面で確認します
- 誰が何を入力したかを管理者が確認できるか。事故が起きたときに追跡できないと、原因も範囲も特定できません
- 利用できるモデルを管理者が制限できるか。業務によって使わせるAIを分けたい場合に効きます
- 退職者のアカウントを即座に止められるか。個人契約が混ざっていると、この操作自体ができません
- データの削除を求めたときの手順と期間。契約終了後にどうなるかを含めて確認します
- 再委託先の有無。提供元が別の事業者に処理を委ねている場合、そこまで含めて把握しておく必要があります
この7項目に書面で答えられるサービスであれば、多くの企業の実務において、社外に出せないとされてきた情報のかなりの部分は扱えるようになります。逆に答えが曖昧なまま使い始めると、社内に置いていないという一点だけを理由に不安が残り続けます。
よくある3つの誤解
誤解1|ローカルなら情報は絶対に漏れない
外部に送信されないのは事実です。ただし漏洩の経路は送信だけではありません。誰が何を入力し、何を持ち出したかを記録していなければ、社内で起きたことは見えません。権限設計とログ取得は、方式にかかわらず必要です。
誤解2|モデルが無料だから費用がかからない
かからないのは従量課金だけです。機材、構築工数、電気代、運用の人件費、モデル入れ替えの検証工数はすべて発生します。3年動かす前提で計算すると、機材費より人の手間の方が大きくなることがあります。当社が支援してきた範囲での実感です。
誤解3|自社のデータを反映させるには学習が必要
多くの場合は不要です。社内文書を検索して回答に反映させるRAGという仕組みで足ります。モデルを学習させ直す前提で検討が止まっている会社は少なくありませんが、そこを外すと選択肢が一気に広がります。
用語の整理
調べていると必ず出てくる言葉を、実務で必要な範囲だけまとめました。
| 用語 | 意味 | 実務でどう効くか |
|---|---|---|
| オープンウェイトモデル | モデルの中身にあたる数値が公開されているモデル | これがあるからローカルで動かせる。ただし公開=商用利用自由ではない |
| パラメータ数(7B・70Bなど) | モデルの規模。Bは10億 | 大きいほど賢いが、必要な機材も重くなる |
| 量子化 | 数値の精度を落としてモデルを軽くする圧縮 | 4bit量子化ならファイルはおおむね4分の1程度に。品質は少し落ちる |
| VRAM | GPUに載っているメモリ | ここに収まらないモデルは、動かないか極端に遅い |
| 推論 | 学習済みモデルに質問して答えを出させる処理 | ローカルLLMでやるのは基本的にこれ。学習ではない |
| コンテキスト長 | 一度に扱える文章の長さ | 長い契約書を読ませるなら、ここが足りているか要確認 |
| ファインチューニング | 既存モデルを自社データで追加学習させること | 専門知識が要る。まず推論だけで足りるかを確かめる方が早い |
| RAG | 社内文書を検索して、その内容を踏まえて答えさせる仕組み | 自社の情報を反映させたいとき、学習させるより現実的な選択肢 |
社内資料を反映させたいという相談の多くは、ファインチューニングではなくRAGで解決します。モデルを学習させ直す必要があると思い込んで検討が止まっている場合は、ここを見直してみてください。
よくある質問
ローカルLLMは無料で使えるのですか?
ローカルLLMとクラウドのAIでは、性能はどのくらい違いますか?
クラウド型に機密情報を入力しても本当に大丈夫ですか?
セキュリティ特化型LLMという言葉を見かけますが、普通のLLMと何が違うのですか?
UPGEAR AIはどちらの方式ですか?
ローカルLLMを動かすには、どのくらいのGPUが必要ですか?
日本語に強いモデルを使いたいのですが、すぐ試せますか?
公開されているモデルは、そのまま商用利用してよいのですか?
社内に置けば、情報漏洩の心配はなくなりますか?
ローカルLLMとクラウド型は、どちらかに決めないといけませんか?
社内資料の内容を答えさせたい場合、モデルを学習させる必要がありますか?
ローカルLLMを試すのに、まず何から始めればよいですか?
ローカルLLMとオンプレミス型は同じ意味ですか?
ローカルLLMは、導入したあとも手入れが必要ですか?
方式を決める段階に入っている場合は、判断の材料をローカルLLMとクラウドLLM、法人はどちらを選ぶべきか|違い・コスト・比較にまとめています。契約・頻度・体制の3つの問い、3年総額の比べ方、業種別の判断例を扱っています。
- オープンウェイトモデルとは|会社で使う前に確かめるライセンスとデータの行き先
- ローカルLLMのおすすめモデル|日本語に強いモデルと用途別の選び方
- ローカルLLMに必要なPCは?Mac・Windows別のメモリとGPUの目安
- ローカルLLM RAGの作り方|社内文書を読ませる手順とクラウドとの差
- ローカルLLMのモデル比較|日本語で業務に使うなら何をどの数字で見るか
- ローカルLLMでできること|社内で使える7つの用途と、できないこと
- ローカルLLMの構築手順|Windows・Macで動かすまでの流れと社内利用で決めること
- MacでローカルLLMを動かす|アプリの選び方と設定、会社で使う注意点
- ローカルLLMを日本語で使うなら国産モデルを選ぶべき?一覧と判断表
- OllamaでローカルLLMを動かすには?インストールから社内で使うまでの手順
- ローカルLLMサーバーは社内で何人まで使える?必要なGPU・メモリと運用の目安
- ローカルLLMの活用事例|企業・自治体・病院が社内で使う8例と共通点
- ローカルLLMは無料?本当にかかる費用(PC・電気代・運用の手間)
- ローカルLLMで文字起こし|会議の録音を外に出さずに文字にする方法
- ローカルLLMで翻訳|社外秘の文書を外に出さずに訳す方法と精度
まとめ
ローカルLLMとクラウド型の法人向け生成AIサービスは、どちらが優れているかではなく、何を優先するかで選ぶものです。データを物理的に社外へ出せない事情があるならローカルLLM、最新AIの性能を初期投資なしで全社に行き渡らせたいならクラウド型が基本線になります。そして方式にかかわらず、社員が使いたくなる公式環境とルールをセットで用意することが、結局は最大のセキュリティ対策になります。
クラウド型のなかでも、1人あたり課金と会社単位の定額では総額の伸び方が変わります。人数別の試算はChatGPT法人プランの料金|人数が増えたときの総額と選び方にまとめています。
法人のAI活用に関する他の記事はAI活用コラム一覧をご覧ください。
最新AIを、安全な管理のもとで全社に
UPGEAR AIは、ChatGPT・Claude・Gemini・Perplexityを国内サーバー管理・学習利用オフのもとで一括利用できるクラウド型の法人向けプラットフォームです。導入から活用定着まで、当社が伴走支援します。
UPGEAR AIの詳細を見る執筆:中里 吉利(コプラス株式会社 代表取締役)/Interactive Advertising Bureau(IAB)公認 Google デジタルマーケティング認定資格・Google アナリティクス認定資格・Google 広告測定認定資格